


Todos los días escucho a alguien decir la palabra «token», algunos andan preocupados por cuántos tokens gastan, otros parecen mencionarlos para sonar más interesantes… y mi hipótesis es que el 93.7% de ellos no saben realmente de lo que están hablando.
Así que en el post de hoy trataré de responder esta pregunta filosófica que aqueja a la humanidad desde hace quinientos años seis meses: ¿Qué @#$%&! es un token?
Empecemos!
Antes de hablar de tokens…
Antes de hablar de tokens, nos toca ver lo que es un Large Language Model (LLM), la tecnología que hace posible que converses con tu asistente favorito.
Si quitamos las 786 capas de marketing y hype, los LLMs son básicamente máquinas que han sido entrenadas para entender los patrones detrás del lenguaje humano. Nada más. Y como máquinas que son, hacen todo esto con modelos matemáticos, es decir, con números.
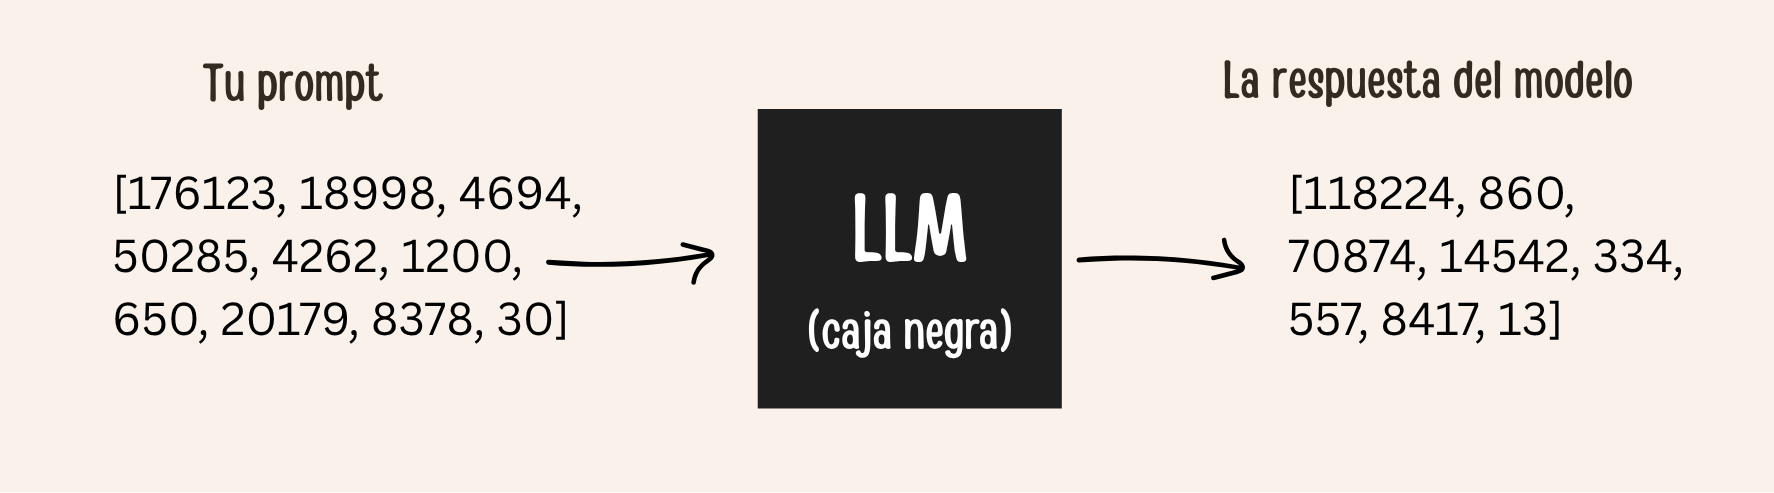
Cuando les haces una pregunta, estas máquinas transforman tu texto en números, responden en números y luego esos números se traducen en texto que cualquier humano puede entender.
Permíteme decirlo una vez más. Un LLM es una máquina donde entran números y salen números. Eso es todo, estos modelos en su vida han visto una palabra.
¿Pero Germán, entonces cómo hacen los LLMs para entender palabras?
¡Buena pregunta! Pues tienen un traductor de números a texto, y ahí es donde entran los tokens!
For your consideration: tokens
Entonces, digamos que tomamos un LLM cualquiera y le hacemos una pregunta filosófica cualquiera:
¿Por qué mis hijos odian el mondongo?
Más allá de la inmensa profundidad de esa pregunta, para que un modelo pueda entenderla primero tiene que transformarla en números.
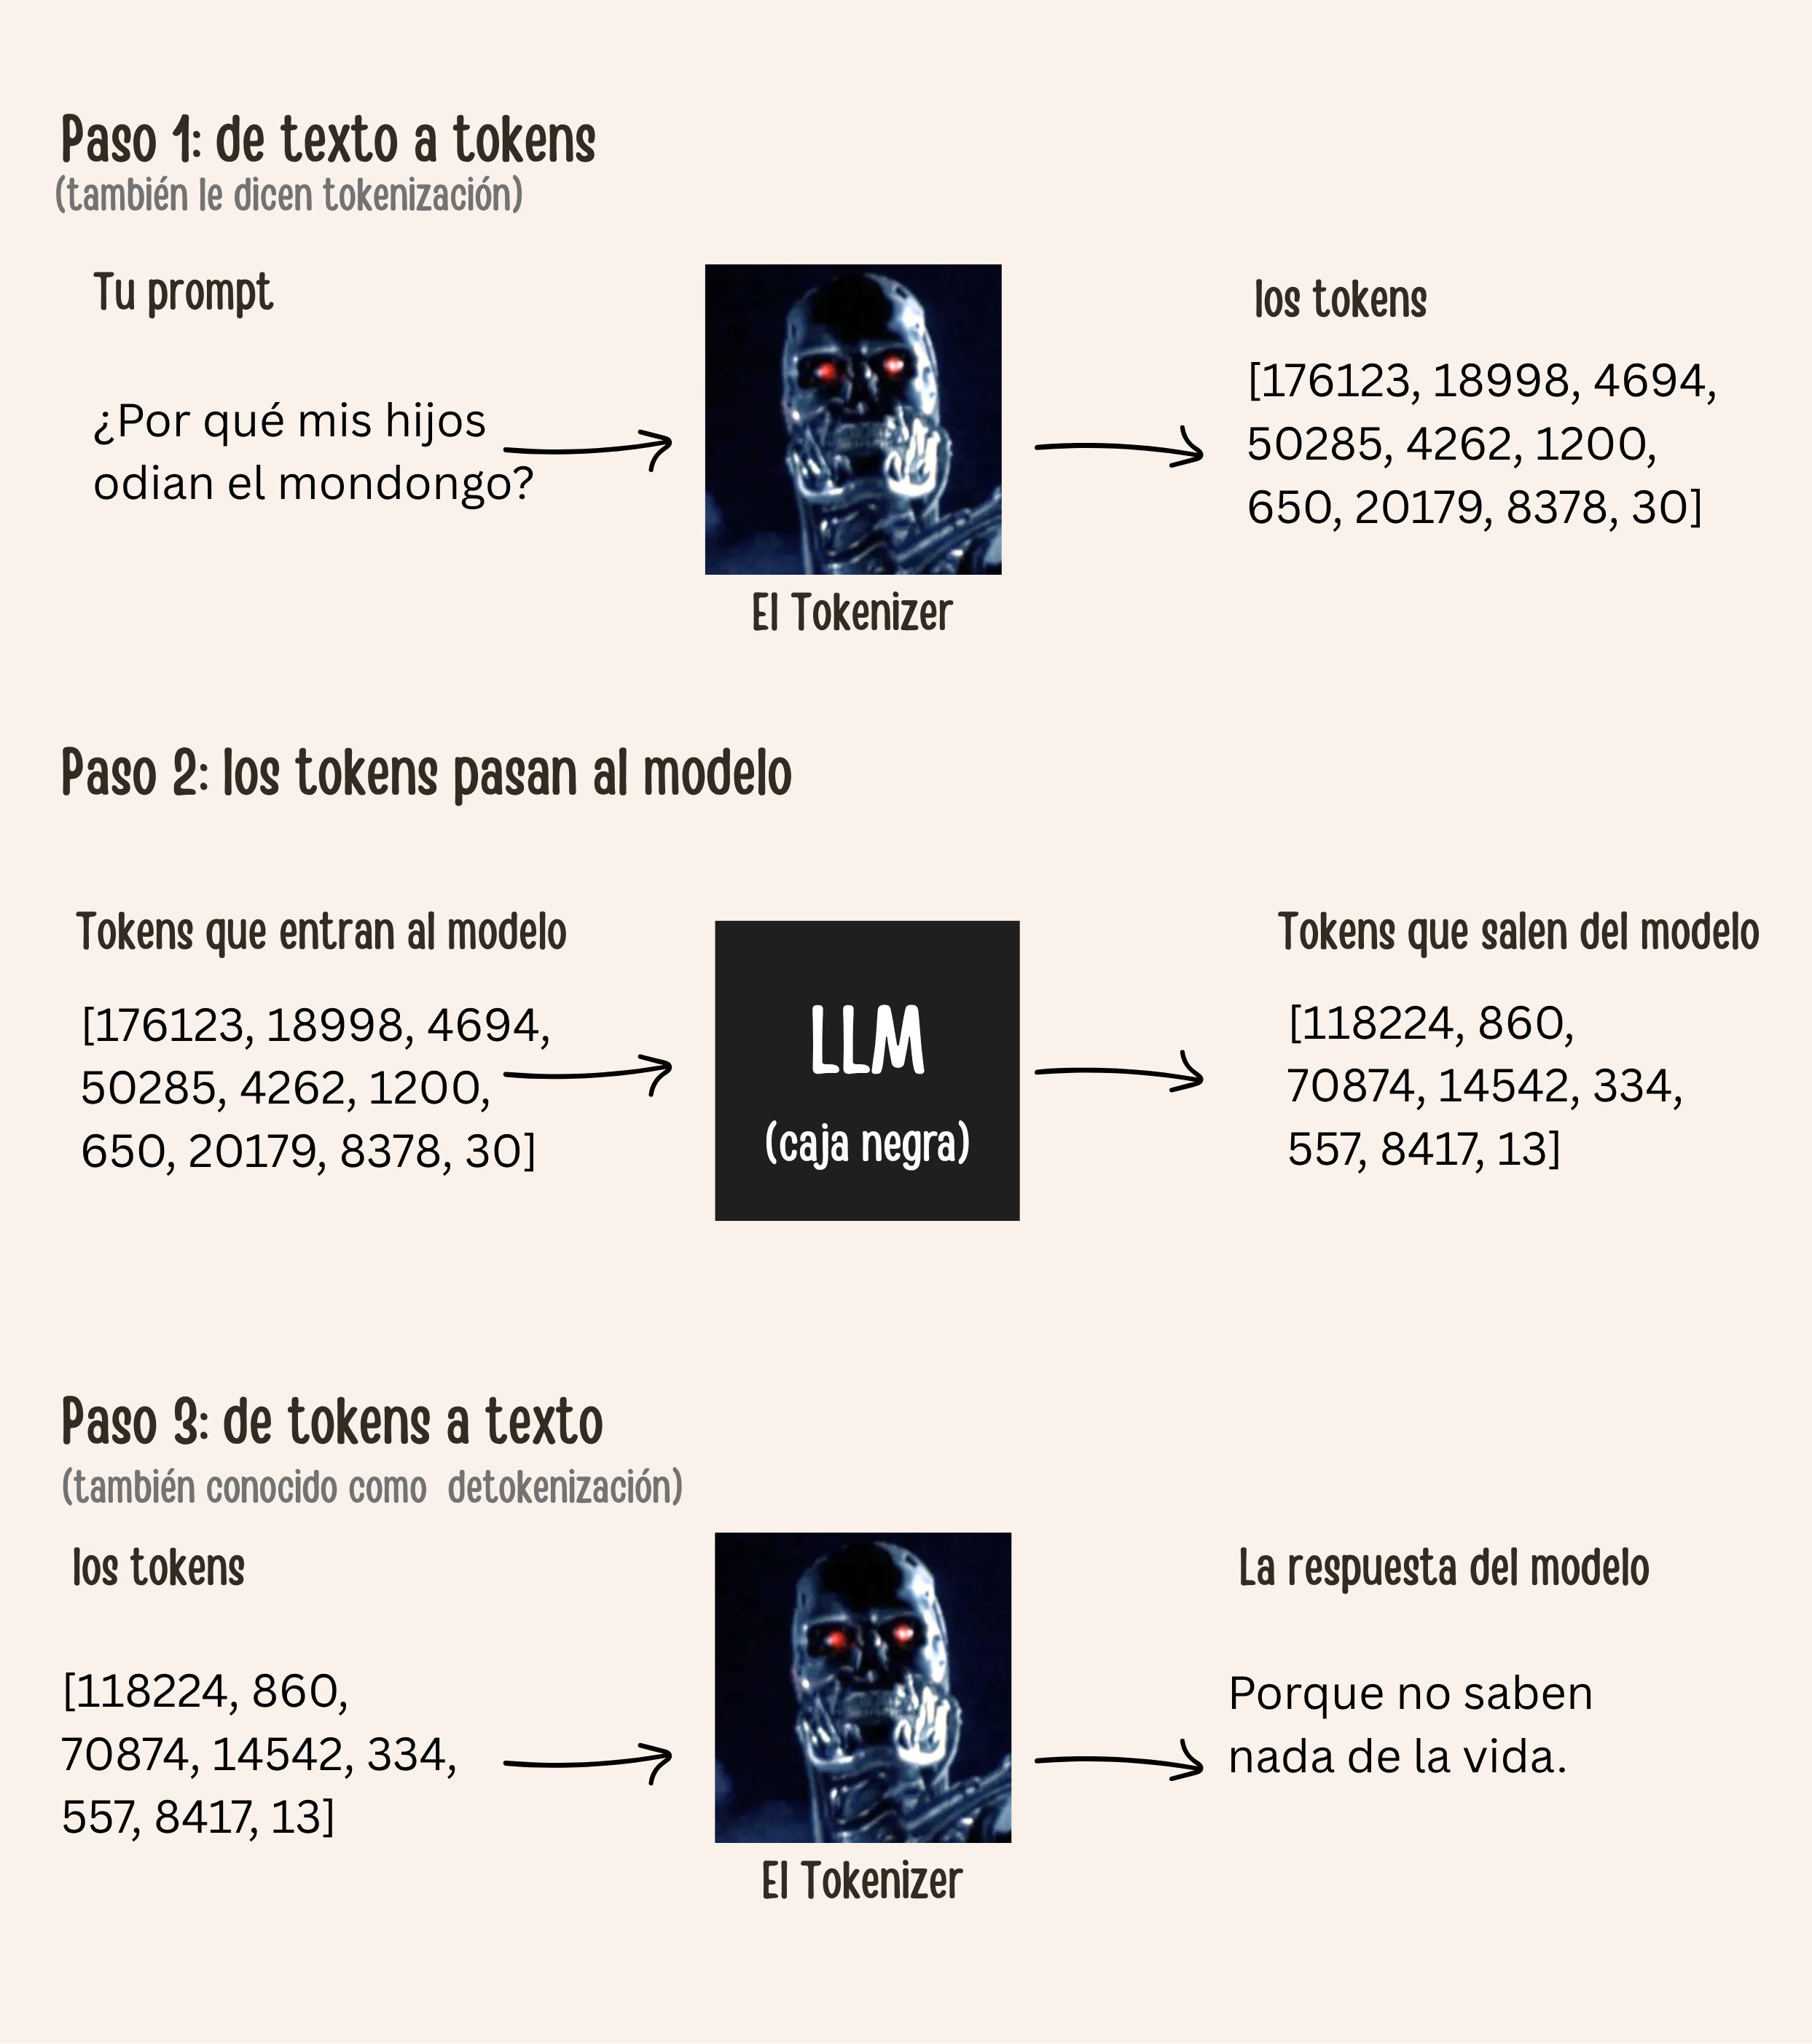
Entonces, donde un humano lee: ¿Por qué mis hijos odian el mondongo?
una máquina lee: [176123, 18998, 4694, 50285, 4262, 1200, 650, 20179, 8378, 30]
¿Ves esa lista de números? Pues cada uno de ellos es un token! 😎
¿Recuerdas que un LLM es una máquina donde entran números y salen números? Pues nuestra máquina responde: [118224, 860, 70874, 14542, 334, 557, 8417, 13]
Este proceso se ve así:
¡Wait a minute, Germán! ¿Cómo sabe la máquina qué números equivalen a un texto?
Pues tiene algo muy parecido a lo que los humanos hemos usado para comprender idiomas por generaciones… un diccionario. Sólo que en vez de ser “Español-Inglés”, “Quechua-Chino” o “Noruego-Catalán”, es un diccionario “Texto-Números”.
Ahora déjame contarte cómo se arma este diccionario y cómo lo usan las máquinas…
Nota: Aún no te he dicho qué significa la respuesta del modelo a mi pregunta filosófica, lo hice a propósito para mantenerte enganchado al post :P
Nuestro diccionario “Texto-Números”
Estoy asumiendo que tienes la edad suficiente para recordar lo que es un diccionario. Si no la tienes, no te preocupes, un diccionario es una tecnología muy muy antigua donde los humanos de antaño usábamos papel para anotar miles de palabras en un idioma acompañadas de su significado en otro.
Así podías tener cosas como:
ハチノス: mondongo → Japonés-Español
innmat: mondongo → Noruego-Español
牛肚: mondongo → Chino-Español
trippa: mondongo → Italiano-Español
OK, creo que con eso entiendes la idea.
La cosa es que aquí estamos armando un diccionario “Texto-Números” o, para ponerlo de otra forma: “Humano-Máquina”.
¿Bueno… entonces se trata de asignarle un número a cada palabra, cierto Germán?
Pues… no! 😅 (si tan sólo la vida fuera tan sencilla). En realidad no es a cada palabra sino a cada pedacito de texto.
Este diccionario lo arma una máquina y lo hace tomando una cantidad brutal de texto, que incluye noticias, libros, artículos científicos, canciones de reggaetón, discusiones en foros, recetas de mondongo, código de programación, poesía, etc, etc.
Ah, y además estos textos están en muchos idiomas diferentes!
Lo que hace la máquina es buscar qué partes del texto se repiten con mayor frecuencia, y no estoy hablando de palabras sino de partes de texto. Pueden ser letras que aparecen juntas, signos de puntuación y a veces palabras completas (si es que aparecieron muchas muchas veces en la data de entrenamiento).
Así el diccionario va separando estos pedazos de texto y viendo qué tanto aparecen en la data. Si aparecieron suficientes veces, se ganan un lugar en el diccionario.
Y cuando digo que se ganan un lugar en el diccionario me refiero a que nuestra máquina les asigna un número, por ejemplo:
! : [0]
“: [1]
#: [2]
…
the: [3086]
…
ongo: [8378]
…mond: [20179]
…
いて: [64655]
…
толст: [176686]
Estos son los famosos tokens. Fíjate cómo cada token tiene un número y que además los tokens incluyen signos de puntuación, palabras y partes de palabras en diferentes idiomas.
Si te fijaste bien, tal vez te diste cuenta de que “ mondongo” tiene dos tokens “ mond” y “ongo”, o mejor dicho, [20179] y [8378].
¿Te imaginas por que para mondongo usan dos tokens en vez de uno solo?
Pues porque lo más probable es que la palabra “mondongo” no haya aparecido tantas veces en la data, pero nuestra máquina se dio cuenta de que “mond” aparece varias veces (almond, diamond, monday, mondador, mondongo) igual que “ongo” (bongo, Congo, hongo, mondongo, expongo) así que le dio un token a cada una.
Al final, la máquina completa su diccionario cuando llega a la cantidad de tokens que la compañía de IA definió. Es como decirle: “Aquí tienes un montón de texto en muchos idiomas, crea tu diccionario de 250,000 tokens”.
Y cada compañía de IA tiene su propia forma de definir sus diccionarios, pero antes de llegar a eso, es momento de contarte cómo nuestra máquina usa el diccionario que acabamos de definir…
Usando el diccionario
Ok, entonces ya tenemos una lista de todos los tokens que puede usar el modelo. Es hora de llamar al Terminator Tokenizer.
Por más apocalíptico que suene el nombre, un tokenizer no es un robot del futuro que ha venido a destruirnos (o por lo menos, aún no lo es). Se trata de una función que toma un texto, lo separa en tokens y luego nos da la lista de números para ese texto.
Siguiendo con nuestro ejemplo…
Tenemos el texto: ¿Por qué mis hijos odian el mondongo?
El tokenizer toma ese texto y lo primero que hace es separarlo en tokens, luego nos da el número que corresponde a cada token. Sería algo así:
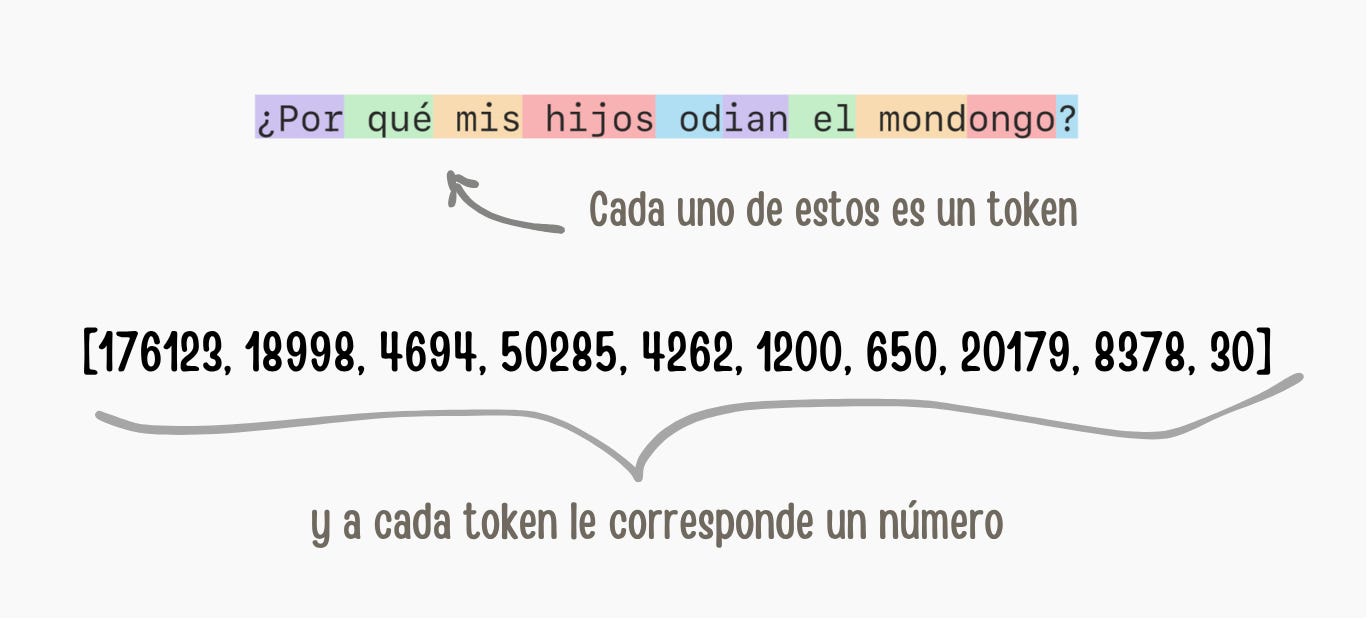
Ese es el trabajo del tokenizer. No hace nada más. No sabe lo que es el mondongo, ni por qué es el ingrediente más terrible del mundo de acuerdo a mis hijos. Es simplemente una máquina que traduce texto a números. Punto. (Aunque tengo que admitir que su nombre me trae recuerdos de película de sci-fi apocalíptica).
Entonces esta lista de 10 números es lo que recibe el LLM. Y como habíamos visto, respondió con 8 números [118224, 860, 70874, 14542, 334, 557, 8417, 13].
Aquí entra de nuevo nuestro T-800 tokenizer, pero ahora en vez de convertir palabras en números, hace lo contrario y convierte números en palabras.
Y así es como [118224, 860, 70874, 14542, 334, 557, 8417, 13] se convierte en:
Porque no saben nada de la vida.
Y ese es el proceso. Te lo pongo también en un grafiquito 😀
Ahora sabes más sobre tokens que el 95% de los humanos, pero aún quedan un par de cosas por ver…
¿Y eso cómo te impacta en el mundo real?
Porque todo en la IA se mide en tokens (y por eso es que no puedo abrir LinkedIn sin leer esa palabra).
Entonces el límite de uso y el precio de una IA dependen de los benditos tokens… pero… no todos los tokens valen lo mismo! ¡Chaaaaaaaaaaan!
Tenemos dos tipos de token, los que entran al modelo (tus prompts) y los que salen del modelo.
Los tokens de entrada (ese es el término técnico) suelen ser baratos, el LLM simplemente los recibe y los procesa todos al mismo tiempo. No pasa lo mismo con los tokens de salida.
Cuando un modelo responde, primero lee el prompt, produce un token, le agrega ese token al prompt, lo vuelve a leer todo desde el comienzo, produce el siguiente token y continúa el ciclo. Por eso es que los tokens de salida son más caros que los tokens de entrada.
Casi lo olvido, también hay tokens de razonamiento, esos que usa el modelo para pensar antes de responder. Estoy seguro que has visto a tu asistente alguna vez hacerlo. Pues esos tokens se suelen cobrar al precio de los tokens de salida.
¿Pero Germán, yo pago mis 20 USD por [inserta tu asistente favorito], qué me importa cuántos tokens usa?
Primero porque tu plan tiene un límite… y, ¿adivina qué? Se cuenta en tokens. Cuando tu asistente te dice que llegaste al límite y que tienes que esperar tres horas y media para seguir conversando, es porque usaste todos tus tokens.
La otra cosa aplica cuando usas el modelo vía API (la forma en la que se conectan los sistemas, sin pasar por el chat). Aquí se paga por cada token, de entrada, de razonamiento y de salida.
Si me has venido leyendo hace un tiempo, seguramente conoces “el stack”. Si no es así, te cuento que cuando hablamos con un asistente no le mandamos simplemente un mensaje sino todos los mensajes que le hemos enviado en la conversación junto con todas sus respuestas (y un par de cosas más) cada vez que lanzamos un prompt. Y todo eso suma tokens!!
Otra cosa que tienes que saber es que la cantidad de tokens depende del idioma!!! ¡Chaaaaaaaan!
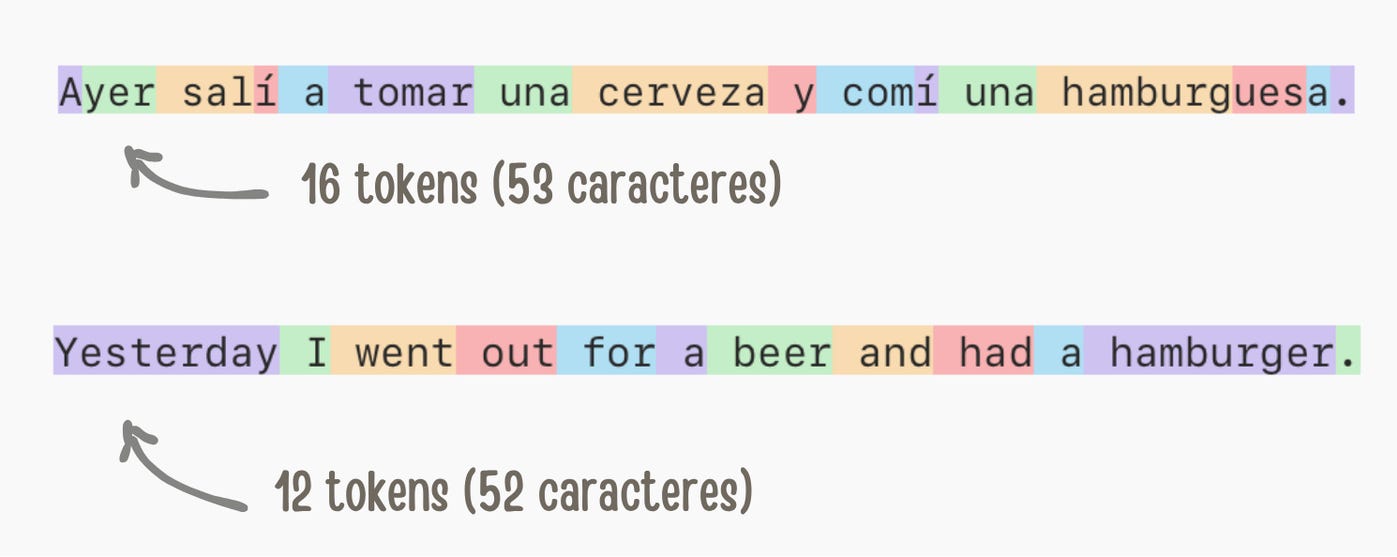
Como lo oyes lees. ¿Recuerdas que los tokens salen de las combinaciones de texto que más se repiten en la data de entrenamiento? Pues la mayoría de esa data está en inglés, mucho menos en castellano y me imagino que casi nada en quechua. Esto significa que el mismo significado puede costar más tokens en español que en inglés. Pero, para qué decírtelo si te lo puedo mostrar?
Tenemos esta frase en dos idiomas que tiene el mismo significado y casi la misma cantidad de caracteres (incluyendo espacios). Mira cómo en español tiene 16 tokens y en inglés sólo 12. Así que más allá del precio de la cerveza en tu país, hablar en español nos puede salir un 33% más caro (hasta en tokens tenemos desventajas 😢).
Si quieres saber más sobre los tokens en diferentes idiomas, puedes ver este post de aquí.
Hay tokens y tokens
Hace un rato te dije que cada compañía tiene su propia forma de definir su diccionario de tokens y lo dejé ahí. Ahora me toca explicarlo.
Cuando una compañía crea un LLM, una de las primeras cosas que tiene que definir es qué montaña de textos va a usar para definir sus tokens y cuántos tokens tendrá su diccionario.
Así, cada compañía usa un conjunto de textos diferentes, siguen siendo miles y miles de textos, pero no son los mismos. Por mi lado, estoy 97% seguro de que todos usan canciones de reggaetón. Por ejemplo, Anthropic puede haber usado “Rakata” de Wisin & Yandel, OpenAI “Gasolina” de Daddy Yankee, y Google, siendo un clásico, podría haber usado “Muévelo” de El General. Lo que quiero decir es que todos tienen contenido similar, pero no necesariamente el mismo.
De la misma manera, una compañía puede haber optado por tener 240,000 tokens, otra por 100,000 y alguna otra por tener un diccionario de 984,356 tokens. Cada una decide lo que es mejor para su modelo.
Estos diccionarios se quedan pegados a sus modelos para siempre, y es lo que les permite entender y producir texto. Si usas el tokenizer de OpenAI para hablar con un modelo de Anthropic, no va a tener idea de lo que le estás diciendo.
Entonces, el mismo texto tiene una cantidad diferente de tokens dependiendo del modelo que estés usando.
Por cierto, los tokens que estoy usando aquí de ejemplo son del tokenizer de OpenAI, GPT-5.x. Si quieres, puedes probarlo tú mismo.
Entonces si alguien te dice (seguramente en LinkedIn) que el modelo de una compañía es más barato que el de otra por millón de tokens, está comparando dos cosas diferentes. Imagínate que el modelo que es más “barato” por millón de tokens gaste más tokens que el otro. Lo que realmente hay que medir es cuánto cuestan las respuestas y las tareas que le mandamos a hacer a esos modelos. Aunque eso ya es cosa de otro post.
Para terminar
Ahora sí, con lo que hemos visto, puedes decir que ya sabes más sobre tokens que el 99.9% de los habitantes del planeta Tierra y estás capacitado para responderle en LinkedIn al primero que ose decir algo que no sea preciso.
Nunca olvides que estamos hablando con máquinas, por más inteligentes y humanas que nos parezcan, y que detrás de todo esto hay números.
Un par de cositas más antes que me olvide:
Llevaba más de un mes sin escribir, disculpen el silencio y gracias por la paciencia.
Estamos a punto de ser 25,000 suscriptores! wooooooo!!
Disculpen si ando un poco podrido con los “expertos en IA” en LinkedIn (o en cualquier otro lugar).
Más de la mitad de este post fue escrita escuchando a Frankie Ruiz, aquí te dejo una canción para que estemos en el mismo mood.
(no me culpes si te pones a bailar 😅).
Ahora sí!
Gracias por leerme y nos vemos en el próximo post!
G
Muy buena explicación, gracias!
Ahora estaré Tokeneizando por un rato :P